


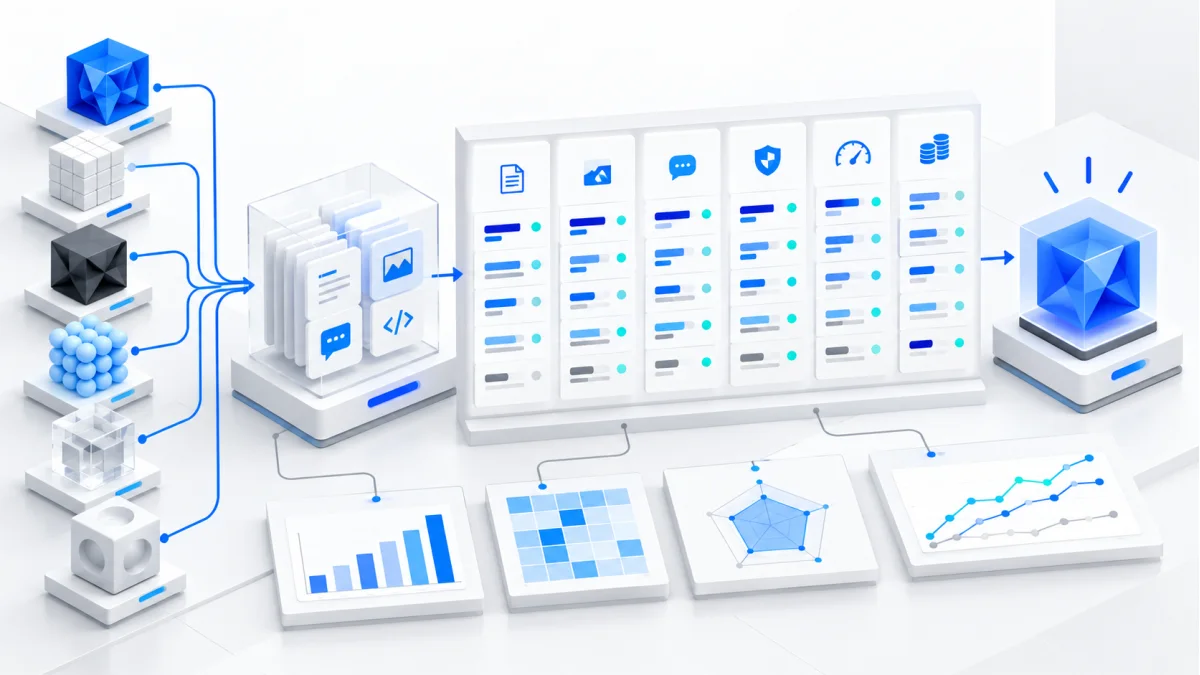
大模型公开榜单回答的是“模型在一组规定测试中表现如何”,企业真正要解决的是“模型在本公司的任务、数据和限制条件下是否可用”。两者可以互相参考,不能互相替代。
斯坦福《2026 AI Index Report》指出,头部模型开发者普遍披露MMLU、SWE-bench等能力基准,但负责任AI指标的披露仍然稀疏。采购方若只比较能力分数,很容易漏掉安全、稳定性和可追溯性。
先确定评测对象和版本
记录模型全名、API版本、测试日期、系统指令、温度、工具权限和地区。在线模型会更新,同一名称在不同日期可能返回不同结果。评测记录缺少版本与参数,之后很难复现。
建立来自真实工作的测试集
样本从哪里来
优先从已完成并经过人工审核的历史任务中抽样,去除不必要的个人信息。每类任务都要覆盖常见案例、信息不足案例、容易混淆的边界案例和恶意输入。初次比较可从50至200条开始,高风险任务需要更大样本和专业人员复核。
为每个样本写清评分规则
参考答案不一定是一段固定文字。分类任务可以有唯一标签,摘要任务可以检查事实覆盖和错误,代码任务可以运行测试,检索任务要核对引用是否真实支持结论。评分规则应在看到模型结果前确定,避免事后迁就某个模型。
七项核心评测指标
- 任务成功率:输出是否满足实际完成条件。
- 事实准确与幻觉率:断言能否由输入或可靠来源支持。
- 指令遵循:格式、字数、禁用项和工具限制是否被遵守。
- 稳定性:同一输入重复运行后,关键结论是否一致。
- 安全性:面对越权、提示注入和危险请求时是否保持边界。
- 延迟与可用性:平均响应、尾部延迟、超时和服务错误率。
- 总成本:模型调用、检索、工具执行、人工复核和失败重试的合计。
MLCommons的AILuminate基准从12类危害评估通用生成式AI系统,并使用公开练习提示与隐藏正式测试,降低针对测试集调参的影响。它适合提供统一安全参照,但官方也明确说明,基准结果不能保证某个系统在所有场景中安全可靠。
自动评分和人工评分如何组合
能确定对错的任务优先使用规则、单元测试和数据库核对。开放式回答可由经过培训的评审人员按照统一量表打分。使用另一个模型做裁判时,应抽样进行人工校准,检查位置偏好、长度偏好和对特定表达方式的偏好。
将错误按严重度分级比平均分更实用。轻微格式问题、可修正事实遗漏和可能造成业务损失的错误,不能计为同等权重。高风险错误即使出现次数少,也可能使模型不适合自动执行。
形成可复查的评测报告
- 公布任务范围、样本数量、测试时间、模型版本和参数。
- 同时报告平均值、失败案例和置信区间或样本波动。
- 保留原始输出、评分理由和人工分歧处理记录。
- 上线后收集真实失败案例,定期加入回归测试集。
FAQ
模型排行榜第一就一定适合业务吗?
不一定。公开榜单的语言、题型、工具环境和评分方法可能与业务不同。榜单适合缩小候选范围,业务测试决定是否采用。
测试集会不会很快过时?
会。产品流程、用户问题和模型版本都会变化。保留稳定的核心回归集,同时把新出现的真实失败案例加入扩展集。
可以完全用大模型自动打分吗?
开放式任务可以使用模型评分提高效率,但必须用人工样本校准。涉及安全、合规或重大业务决策时,不能取消专业人员复核。
如何比较不同价格的模型?
同时报告每个成功任务的成本和人工修改时间。按千Token价格比较,无法反映失败重试、长上下文和复核成本。
参考资料
- Stanford HAI:2026 AI Index Responsible AI
- MLCommons:AILuminate
- Anthropic:Demystifying evals for AI agents
编辑说明:文中的样本规模用于说明初步评测方法,并非适用于所有行业的合规门槛。高风险应用应由相关专业人员制定测试标准。

